基于美国底座的两个决策模型
Base Labs 是 Baseten Model APIs 背后的研究团队,于 11 月 20 日发布了 bison-1 和 groundhog-1。两者都是基于 Google Gemma 4 后训练的决策模型,现已通过 Baseten 上的 BYOK System One 路由上线 AnyRouter。
决策模型不撰写答案。你提供一段状态和一组命名问题,模型为每个问题返回结构化结果:选中的选项、是/否概率,或评分。这适用于路由、分类、策略检查和按量规打分——你需要的是可以设阈值的概率,而不是需要解析的文本。
| Model | Backbone | Parameters | Context | Price per 1M input |
|---|---|---|---|---|
| Bison 1 | Gemma 4 31B | 31B | 128K | $0.10 |
| Groundhog 1 | Gemma 4 26B-A4B | 26B (about 4B active) | 128K | $0.035 |
两者都接受状态中的文本和图像。128K 上下文是上一代产品的八倍,当改变决策的细节深藏于长策略文档或会话历史中时,这一点很重要。
准确度如何?
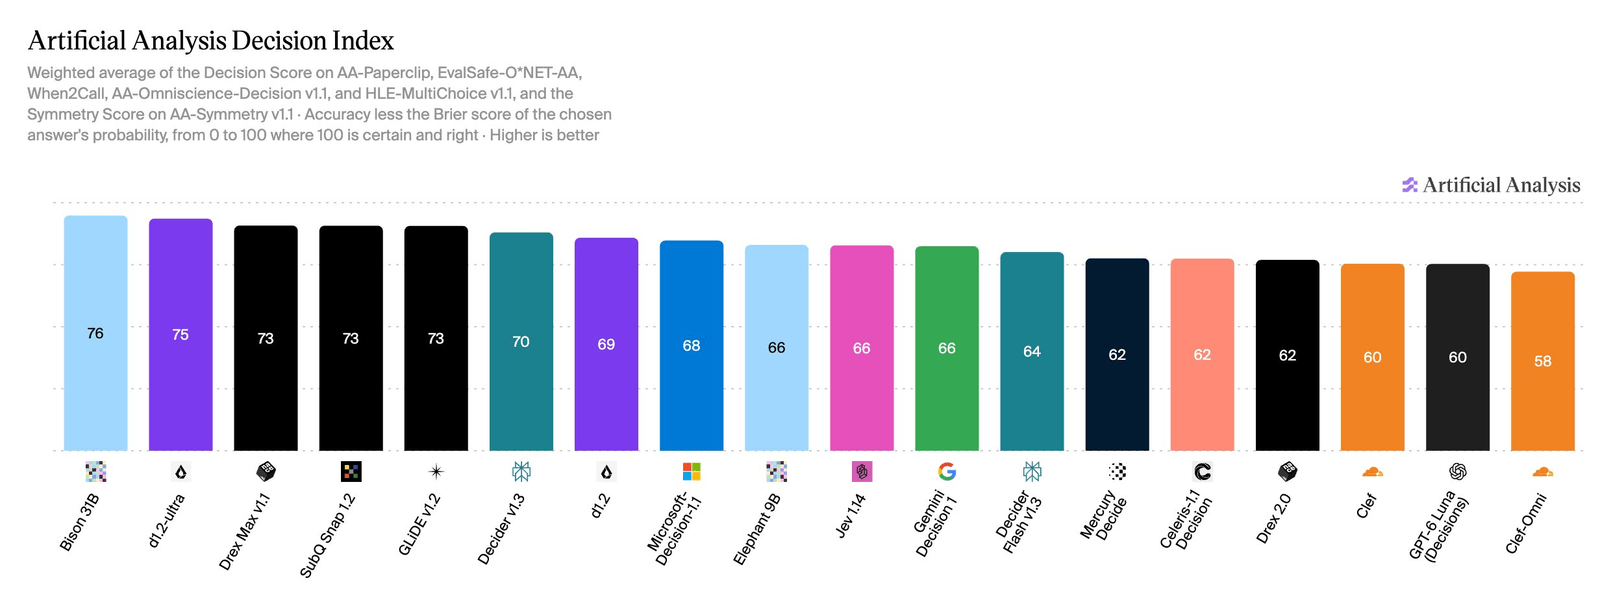
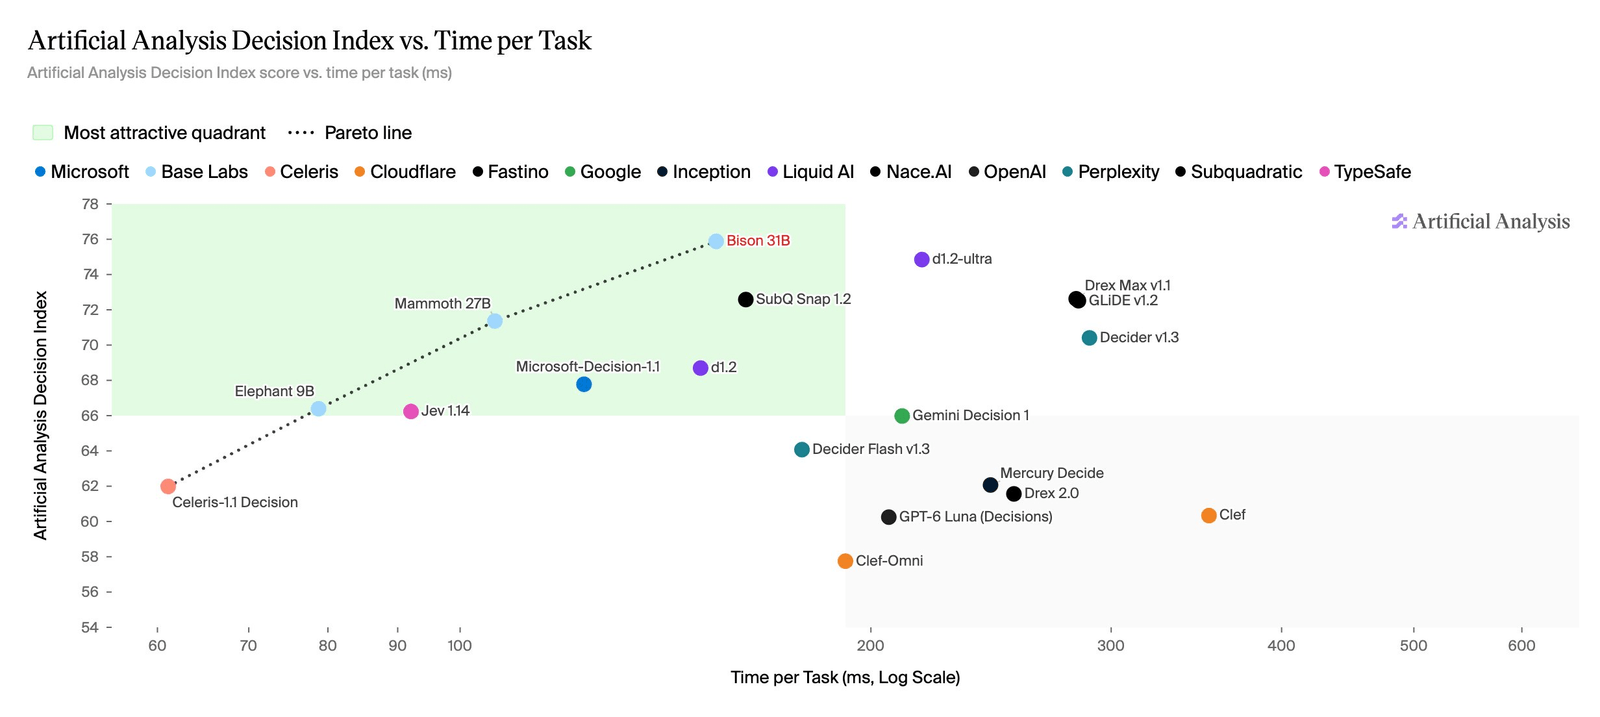
在独立决策指数 v2.1 上,bison-1 在 19 个决策模型中排名第一,得分 76,领先于得 75 的 d1.2-ultra 和得 71 的 mammoth-1。它的 Brier 分数也是该指数上最低的 0.14,意味着它报告的置信度接近实际正确率。Baseten 预计 groundhog-1 在官方指数上达到 mammoth-1 的水平,但发布时未公布分数。
Independent decision index v2.1
Scores published in the Baseten launch post.
在 AnyRouter 上使用
两个模型都仅支持 BYOK。在 Dashboard → BYOK 添加 Baseten API 密钥,由 Baseten 直接向你的账户计费;AnyRouter 对该路由不收费。模型 ID 是 baselabs/bison-1 和 baselabs/groundhog-1。
anyr decision --model "baselabs/bison-1"anyr decision --model "baselabs/groundhog-1"底层调用会向 Baseten 原生 /v1/systemone 端点发送 {model, state, questions}。问题类型为 choice、noul(是/否)和 score(按量规评分)。每个答案都带概率,choice 和 score 还带置信度值。
它们不是什么
它们是结构化分类器,不是聊天模型。它们不维持对话,也不撰写长文本。Baseten 还指出,API 接受的图像 URL 必须是 base64 数据 URL,或来自 Amazon S3、Google Cloud Storage 或 Azure Blob Storage 的对象。